将 Anthropic、OpenAI、Google 的编程 AI 模型按 Terminal-Bench 得分与单次任务成本绘制在同一图表上,辅助选型。
产品信息
- 形态
- 网页应用
- 分类
- 人工智能 › AI 评测与可观测
- 定价
- 免费
- 首发日期
- 2026年11月20日
- 收录时间
- 2026年11月20日
概览
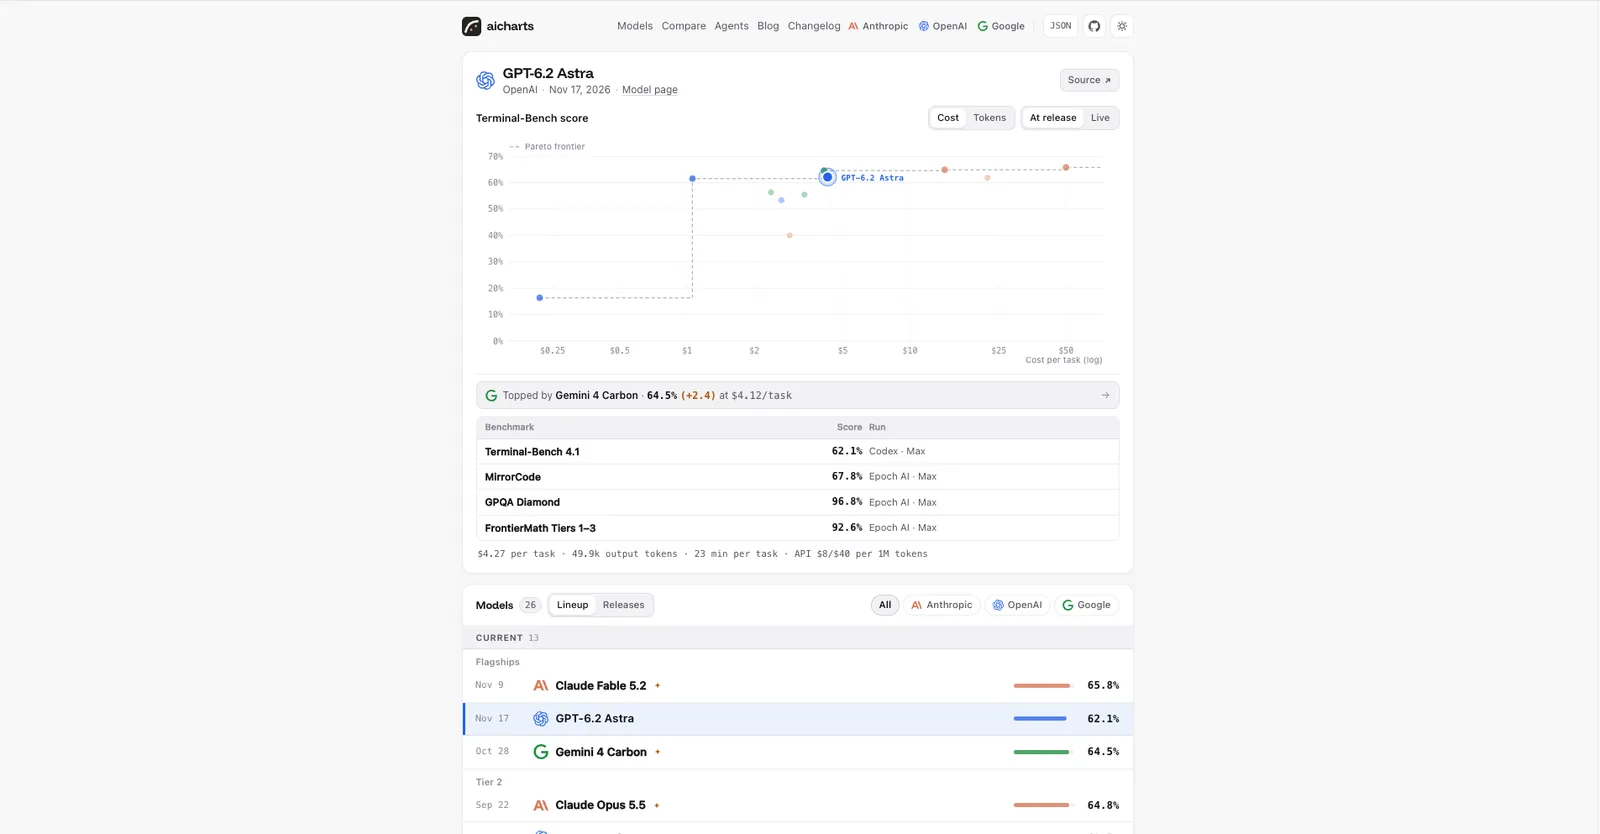
aicharts 是一个网页应用,用于可视化比较不同 AI 模型在编程任务中的表现与成本。它将 Anthropic、OpenAI 和 Google 发布的模型放在同一张图表中,横轴为单次任务成本(Cost per task),纵轴为 Terminal-Bench 基准测试得分,帮助用户在预算范围内找到合适的编程模型。
主要能力
- 图表对比:以散点图形式展示各模型的 Terminal-Bench 得分与每次任务的美元成本,直观呈现性价比关系。
- 多基准数据:除 Terminal-Bench 外,还提供 MirrorCode、GPQA Diamond、FrontierMath Tiers 1–3 等基准的得分数据。
- 成本明细:展示每个任务的 token 消耗量(如 output tokens)、平均耗时以及 API 定价(每百万 token 的输入/输出价格)。
- 模型分层浏览:将模型按 Flagships、Tier 2、Tier 3、Smallest 分层,并区分当前可用(Current)与已替代(Superseded)状态。
- 数据来源透明:数据引用自 Terminal-Bench leaderboard(Apache-2.0)、Epoch AI(CC-BY-4.0)以及 LiteLLM model prices(MIT)。
适合谁
需要在多个 AI 编程模型之间做技术选型的开发者或团队,尤其是关注成本与性能平衡的场景。通过 aicharts,用户无需手动整理各家定价与跑分数据,即可在一张图上完成横向比较。
功能特性
- 得分与成本图表:将 Terminal-Bench 得分与单次任务成本绘制在同一图表上,便于直观对比。
- 多厂商模型覆盖:收录 Anthropic、OpenAI、Google 的编程相关模型。
- 多项基准测试:提供 Terminal-Bench、MirrorCode、GPQA Diamond、FrontierMath 等基准得分。
- Token 与耗时明细:展示每次任务的 output tokens 数量与平均执行时间。
- API 定价信息:列出每百万 token 的输入与输出价格。
- 模型分层分类:按 Flagships、Tier 2、Tier 3、Smallest 对模型进行层级划分。
- 当前与历史状态:区分当前可用模型与已被替代的历史模型。
- 开源数据来源:数据来自 Apache-2.0、CC-BY-4.0、MIT 许可的公开来源。
版本更新
新版本提醒我 首个版本 · aicharts
Q&A
- aicharts 的数据来源是什么?由 AI 生成
- 数据来自 Terminal-Bench leaderboard(Apache-2.0 许可)、Epoch AI(CC-BY-4.0 许可)以及 LiteLLM model prices(MIT 许可)。
- 图表的横轴和纵轴分别代表什么?由 AI 生成
- 纵轴是 Terminal-Bench 得分,横轴是单次任务成本(Cost per task),用于展示模型性能与花费的关系。
- 支持哪些厂商的模型?由 AI 生成
- 目前收录了 Anthropic、OpenAI 和 Google 三家厂商的编程相关模型。
- 除了 Terminal-Bench 还有其他基准吗?由 AI 生成
- 有。页面还展示了 MirrorCode、GPQA Diamond 和 FrontierMath Tiers 1–3 的得分数据。
收藏
这个产品还没有主理人
由平台收录或原作者已注销。如果它是你的作品,证明与它的关系后即可成为主理人。
认领这个产品